从 180ms 的长 TCP 到稳定 QUIC:我的家庭内网为什么迁移到 Hysteria 2
上一篇《一次 4 Mbit/s 下载,为什么让内网穿透延迟从 40ms 卡到 180ms?》里,我把一条 Xray reverse 长寿命 TCP 的问题拆了出来:新连接仍是 40 多毫秒,承载 reverse mux 的旧连接却会在持续传输后固定到 180–200ms,而且停止下载也不恢复。
后来我把一条 reverse 拆成 management 和 bulk lanes,再加上只重建异常 lane 的健康协调器。这确实保护了 SSH 和 PVE Web,但本质没有改变:大文件仍然跑在长寿命 TCP 上,监控只能在劣化后把连接切断重建。
所以这次不再继续给 TCP 打补丁,而是问一个更直接的问题:如果把家庭内网的数据路径换成 QUIC/UDP,能否避免那种与旧 TCP 五元组绑定的持久高延迟?
最终我把生产入口迁移到了 Hysteria 2。真正费时间的并不是写两份 YAML,而是如何证明新路径确实更稳、如何限制它不能变成公网代理,以及如何让防火墙丢失或机器断电后保持 fail-closed。
本文中的域名、地址、Realm 名称、证书信息和身份凭据均已替换;性能数字来自真实测试记录。
一、最终拓扑:公网代理和家庭入口只保留一种客户端协议
旧结构中,客户端先连接公网中继,再由中继通过 Xray reverse TCP 回家:
  flowchart LR
client["Mac / iPhone"]
relay["公网中继 ycy"]
mux["Xray reverse mux<br/>长寿命 TCP"]
home["VM103 / 家庭网段"]

    client -->|"代理协议"| relay
    relay --> mux
    mux --> home
新结构仍保留公网中继,但客户端只需导入一个 Hysteria 2 节点。普通公网流量直接从 ycy 出站;只有家庭网段才转入 ycy 本机的 SOCKS5,再经私有 Realm 建立的 Hysteria 2 连接进入 VM103:
  flowchart LR
client["Shadowrocket / PassWall2"]
relay["ycy<br/>Hysteria 2 UDP/443"]
internet["Internet"]
socks["SOCKS5<br/>127.0.0.1:18007"]
realm["私有 Realm<br/>仅做 rendezvous"]
vm["VM103<br/>Hysteria Server"]
lan["192.168.22.0/24"]

    client --> relay
    relay -->|"普通目标"| internet
    relay -->|"家庭网段"| socks
    socks -. "交换地址" .-> realm
    realm -. "交换地址" .-> vm
    socks == "打洞后的直接 QUIC/UDP" ==> vm
    vm --> lan
Realm 只负责让两端找到彼此,不转发业务数据。实际抓包看到的是 ycy 与家庭公网出口之间的双向 UDP,而不是流量绕经 Realm 服务。
二、先写停止条件,而不是先装软件
这套链路承载真实的家庭管理面,我不希望一次 PoC 把已有入口一起打掉。因此验证被拆成三个阶段:
  flowchart TD
s0["阶段 0:只读基线<br/>端口、服务、STUN、回滚"]
s1["阶段 1:独立连通性 PoC<br/>只允许 VM200:80"]
s2["阶段 2:TCP / UDP 对照<br/>阶梯、大文件、持续流"]
harden["持久化与安全加固<br/>私有 Realm + fail-closed ACL"]
prod["生产迁移"]

    s0 -->|"基线健康"| s1
    s1 -->|"正向与负向检查通过"| s2
    s2 -->|"性能证据通过,但恢复设计有缺口"| harden
    harden -->|"断电恢复与短复验通过"| prod
开始前就确定几个硬停止条件:management lane 异常、可用 bulk lane 低于安全下限、Hysteria ACL 负向测试失败、无法确认实际 UDP 路径,或者回滚方式不明确时,都不开始压力测试。
阶段 0 只采集状态。例如用 ss -ti 记录六条现有 reverse TCP 的 RTT、minrtt、拥塞窗口和重传:
1 | pid=$(systemctl show xray-pve-bridge@bulk-1 \ |
再检查 UDP 监听、系统 drop 和服务状态,但不修改配置:
1 | sudo ss -Hlunp |
这样后续每个结果都有变更前的对照,也能证明 PoC 没有偷偷重启 Xray 或六条生产 lane。
三、第一个坑:连得上 Realm,不代表 STUN 走对了
PoC 中 VM103 位于 NAT 后,ycy 有公网地址。两端先向 Realm 注册,再通过 STUN 观察自己的公网映射并同时发 UDP 包,理论上正适合这种场景。
第一次尝试却失败了。VM103 能解析 Realm、能访问 HTTPS,也能收到 STUN 响应,但抓包发现 STUN 被 OpenWrt 的 PassWall2/Fake-IP 透明代理接管,STUN 看到的是错误出口。“有响应”与“响应能用于打洞”是两回事。
我没有粗暴放行整个 UDP/3478,也没有把 198.18.0.0/15 全部加入白名单,而是只加入一个三维匹配的临时例外:
1 | # 仅示意;地址均为文档保留地址 |
范围同时绑定:
- VM103 的源地址;
- 三个预先核验的 STUN IPv4;
- UDP 目标端口 3478。
规则加载后,一次 48B Binding Request 收到 68B 响应,随后抓包确认业务阶段是 ycy 和家庭公网出口直连。PoC 的 SOCKS 只监听回环地址:
1 | ss -Hltnp 'sport = :18007' |
1 | LISTEN 0 4096 127.0.0.1:18007 0.0.0.0:* users:(("hysteria",pid=...,fd=...)) |
应用 ACL 当时只允许一个隔离测试目标 192.0.2.20:80,其他全部拒绝。PVE、OpenWrt、SSH、NAS、普通公网地址分别做一次短连接负向检查,全部返回 SOCKS5 拒绝。
1 | curl --socks5-hostname 127.0.0.1:18007 \ |
1 | curl: (97) cannot complete SOCKS5 connection |
四、第二个坑:客户端限速不是链路限速
上一篇已经踩过一次:在下载端运行 curl --limit-rate,只能限制应用读取速度。多层 TCP 接收窗口与缓存仍可能让内网源端提前发送大量数据,无法证明 reverse 外层实际只跑在指定档位。
这次直接在 VM200 的源端出口用 HTB 整形,并且只匹配临时 HTTP 服务的源端口:
1 | dev=ens18 |
每轮都读取整形类的累计字节,而不是相信 curl 显示的瞬时速度:
1 | tc -s class show dev ens18 classid 1:10 |
测试脚本用 trap 删除 HTB 并恢复原来的 fq,避免一次中断把 VM200 永久留在限速状态:
1 | cleanup() { |
五、对照结果:TCP 在最低档复现,QUIC 没有状态跃迁
Hysteria 依次完成 2、3、4、5 Mbit/s 的五分钟轮次。源端实测分别为 1.997、2.993、4.017、4.982 Mbit/s,UDP InErrors 和 RcvbufErrors 增量均为 0,management HTTP 全部返回 200。
TCP reverse 刚跑到最低的 2 Mbit/s 就复现了问题:bulk-1 从约 44ms 跃迁至 179–193ms,新建 TCP 仍约 47ms。健康协调器连续三次确认后只重建这一条 lane,PID 从 489 变为 6202,RTT 回到 46.942ms。为了不继续消耗其他 bulk lane 和恢复预算,TCP 的 3/4/5 Mbit/s 轮次没有再执行。
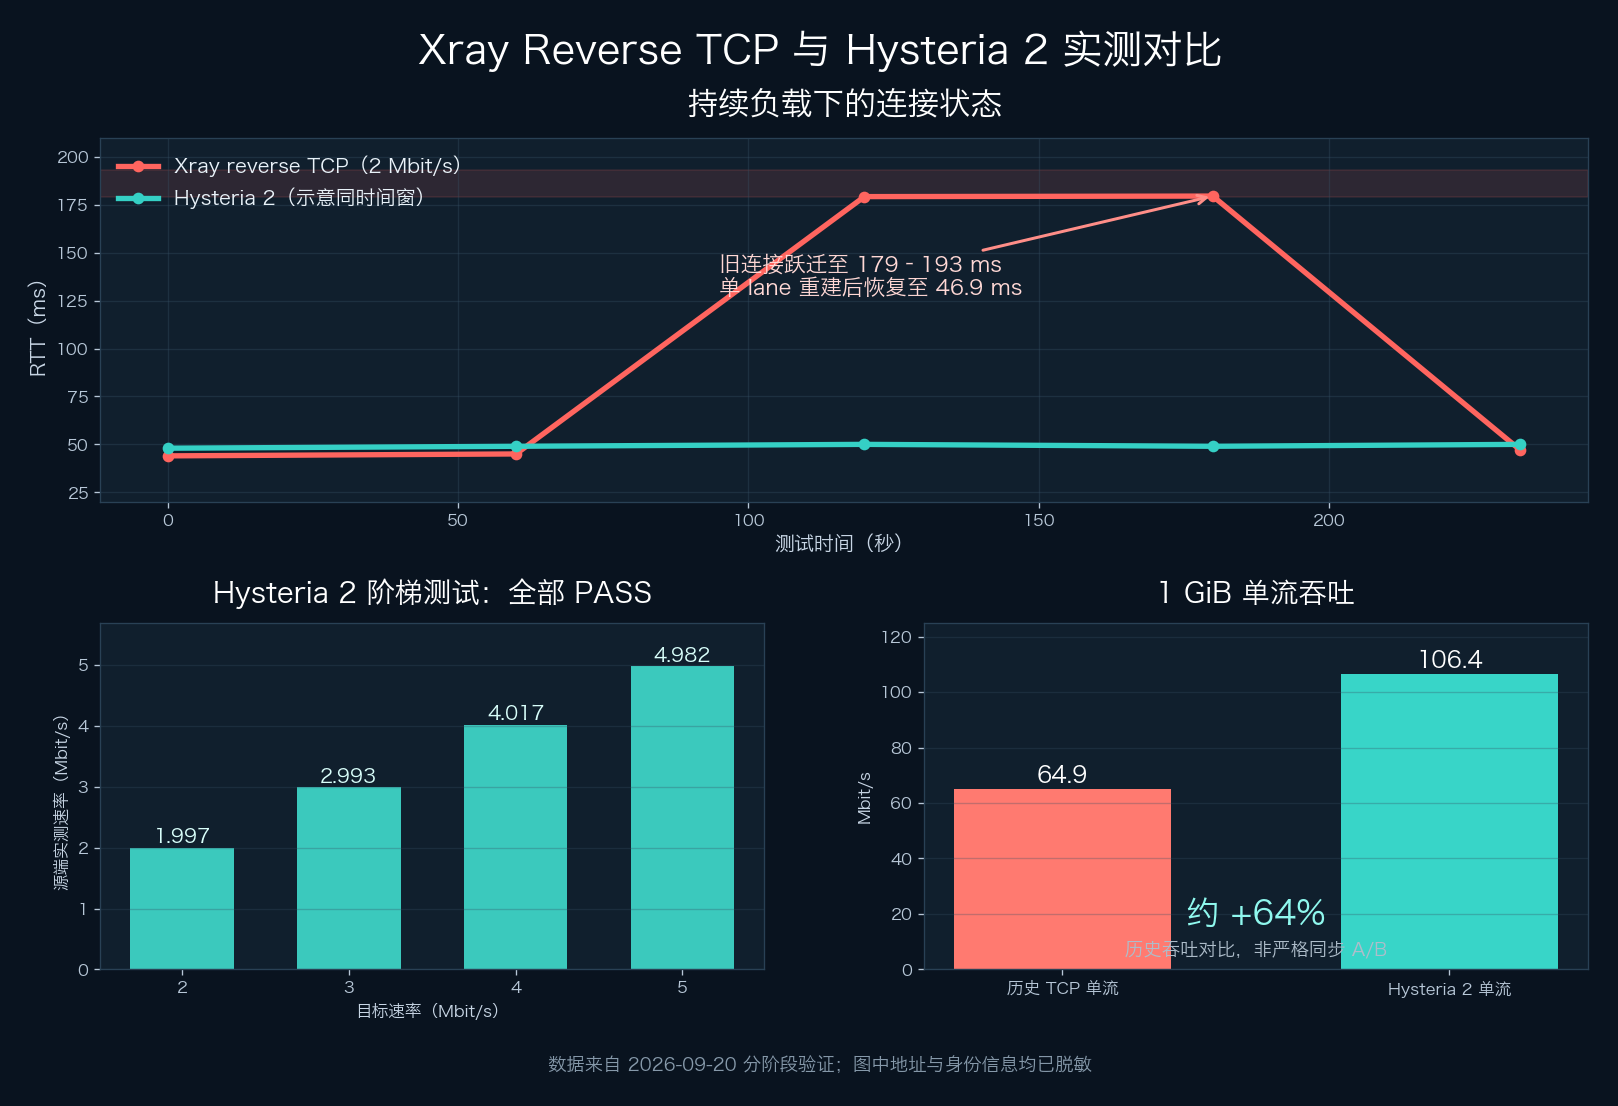
完整的大文件与持续流结果如下:
| 测试 | 结果 | 吞吐 / 时长 | 完整性与影响 |
|---|---|---|---|
| Hysteria 2 单 HTTP/1.1,1 GiB | HTTP 200 | 80.738s,106.4 Mbit/s | SHA-256 匹配;UDP drop 0 |
| Hysteria 2 四路 Range,1 GiB | 4×206 | 最慢 81.291s,约 105.7 Mbit/s | 四段重组 SHA-256 匹配 |
| Hysteria 2 持续流 | HTTP 200 | 4 Mbit/s,1800s | management 全部 200 |
| 历史 TCP 单流 | 历史记录 | 约 64.9 Mbit/s | 非同时间、同文件 A/B |
1 GiB 文件下载后用哈希验证,不以 HTTP 200 代替完整性:
1 | sha256sum /tmp/hysteria-stage2.bin |
1 | 49bc20df15e412a64472421e13fe86ff1c5165e18b2afccf160d4dc19fe68a14 /tmp/hysteria-stage2.bin |
四路 Range 每段都是 268,435,456B,重组哈希一致,但总耗时比单流慢约 0.7%。这说明在本次链路里,四个业务 stream 仍共享同一 QUIC connection 和总拥塞状态;拆流没有免费带来额外带宽。
Hysteria 的 106.4 Mbit/s 相比历史 TCP 的 64.9 Mbit/s 约高 64%,但这只是历史归一化对比。因为 TCP 在最低档已经触发生产恢复,我没有为凑结果再用当前 TCP 下载同一个 1 GiB 文件。因此这组吞吐不能被包装成严格同步 A/B,也不能单独作为迁移依据。
六、最有价值的一次失败:PVE 断电
阶段 2 进行到一半时,PVE 宿主意外断电重启。这个事件与 Hysteria 压测无关,却比一次顺利跑完更有价值:VM103 和 VM200 虽然恢复了,阶段 1 的 Hysteria Server 与临时 inet hysteria_poc table 却没有随开机回来;ycy Client 看起来仍是 active,但 SOCKS 请求全部失败。
更隐蔽的是,OpenWrt Fake-IP 数据库重建后,Realm 地址从一个 198.18.x.x 变成了另一个。旧 ACL 即使被机械恢复,也会指向错误地址。
这迫使我把“服务能不能重启”升级为“依赖能否按安全顺序重建”:
1 | network-online |
如果防火墙不存在,Server 就不应该运行;如果运行中规则漂移,健康检查应先停止 Server,而不是尝试放宽规则让它“恢复可用”。
七、从公共 Realm 切到私有 Realm
公共 Realm 很适合验证机制,却是 best-effort 服务,而且配合 OpenWrt Fake-IP 会引入地址漂移。生产方案最终在 ycy 自建固定版本的 Realm Server,使用独立 TCP 端口和强随机 token:
- TCP/443 继续留给原服务,Realm 使用独立的示例端口
18443; - token 与随机 Realm 名称放在 root-only systemd credential 中;
- 进程命令行、Git、日志和本文都不出现 token;
- VM103 直接访问 ycy 的固定公网地址,不再把 Realm Fake-IP 写进 ACL;
- rendezvous 失败时明确失败,不回退公共 Realm。
生产部署不使用 curl | sh。二进制固定版本并在安装前校验摘要,下面仅展示流程,哈希为示例值:
1 | curl -fL -o /tmp/hysteria \ |
八、双层 ACL:应用拒绝一次,内核再拒绝一次
只依靠 Hysteria 的应用 ACL 风险太高。配置错误、版本回归或启动时读错文件,都可能把家庭服务器变成未经授权的出口。
因此 VM103 同时保留两层边界:
- Hysteria ACL 只允许获批的家庭网段和端口;
- nftables 按 Hysteria 专用 UID 限制进程实际能访问的目标,最后一条明确
reject。
防火墙生成器先输出完整 batch,再做语法检查,最后用单一事务替换专用 table:
1 | sudo nft --check -f /run/hysteria-home/firewall.nft |
关键规则的结构类似:
1 | table inet hysteria_home { |
注意这里没有全局 flush ruleset,也没有把整个 Fake-IP 网段或任意 RFC1918 网络放开。规则只约束专用 UID,不影响系统其他进程。
systemd 再把启动顺序写成依赖,而不是靠运气:
1 | [Unit] |
验收时我手工删除专用 nft table,再运行健康检查:Server 被停为 inactive。重建 ACL 后才能再次启动。这个负向测试比单纯看到 active (running) 更重要。
九、断电恢复和迁移前复验
受控重启 VM103 后,日志显示防火墙先完成,Server 下一秒才启动。五秒后正向 HTTP 返回 200,PVE、OpenWrt、SSH 和普通公网目标仍全部被拒绝。
1 | systemctl is-active hysteria-home-firewall.service |
私有 Realm 持久化后又做了一轮 4 Mbit/s、五分钟短复验:源端实测 3.985 Mbit/s,38 次 management HTTP 全部 200,UDP InErrors/RcvbufErrors 增量为 0,四条 bulk PID 不变,协调器没有动作。
至此才具备生产迁移的条件。迁移保持一个原则:故障时明确失败,不悄悄回退到公共 Realm、旧站点或更宽松的 ACL。
十、回滚也必须是一等公民
生产变更前写好的回滚顺序是:
1 | # 1. 先撤销客户端对新 HOME 通道的使用 |
回滚过程中不重启 ycy Xray、不同时重启全部 reverse lane,也不自动恢复公共 Realm。若要回到公共 PoC,必须重新核验当时的地址后再生成 ACL。
十一、VLESS/REALITY 与 Hysteria 2 实际测速对比
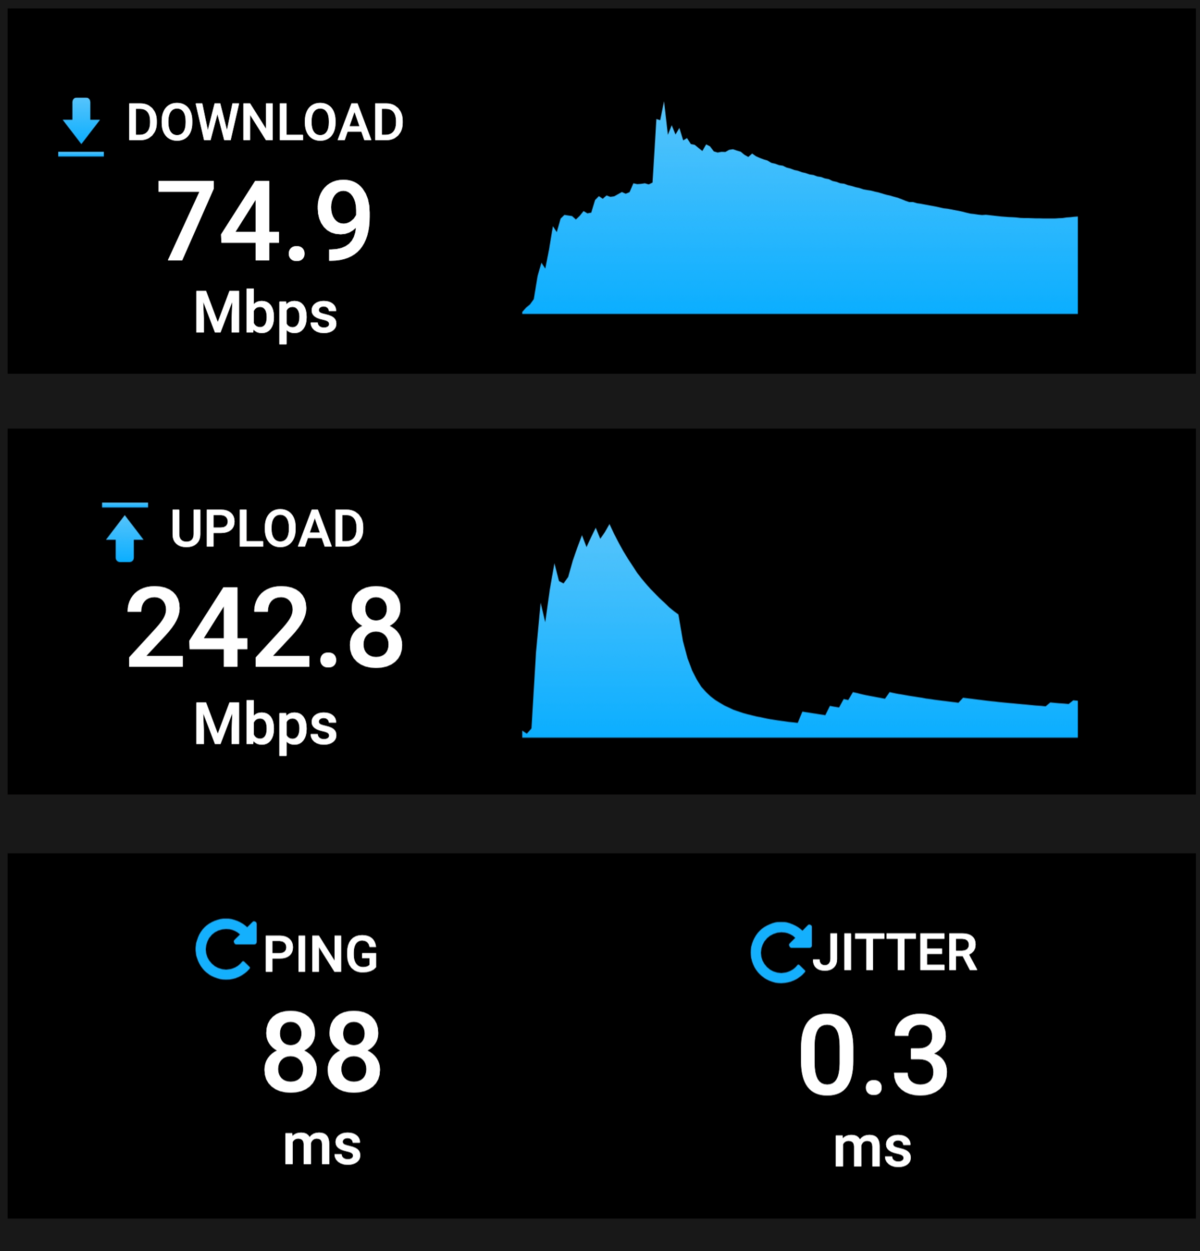
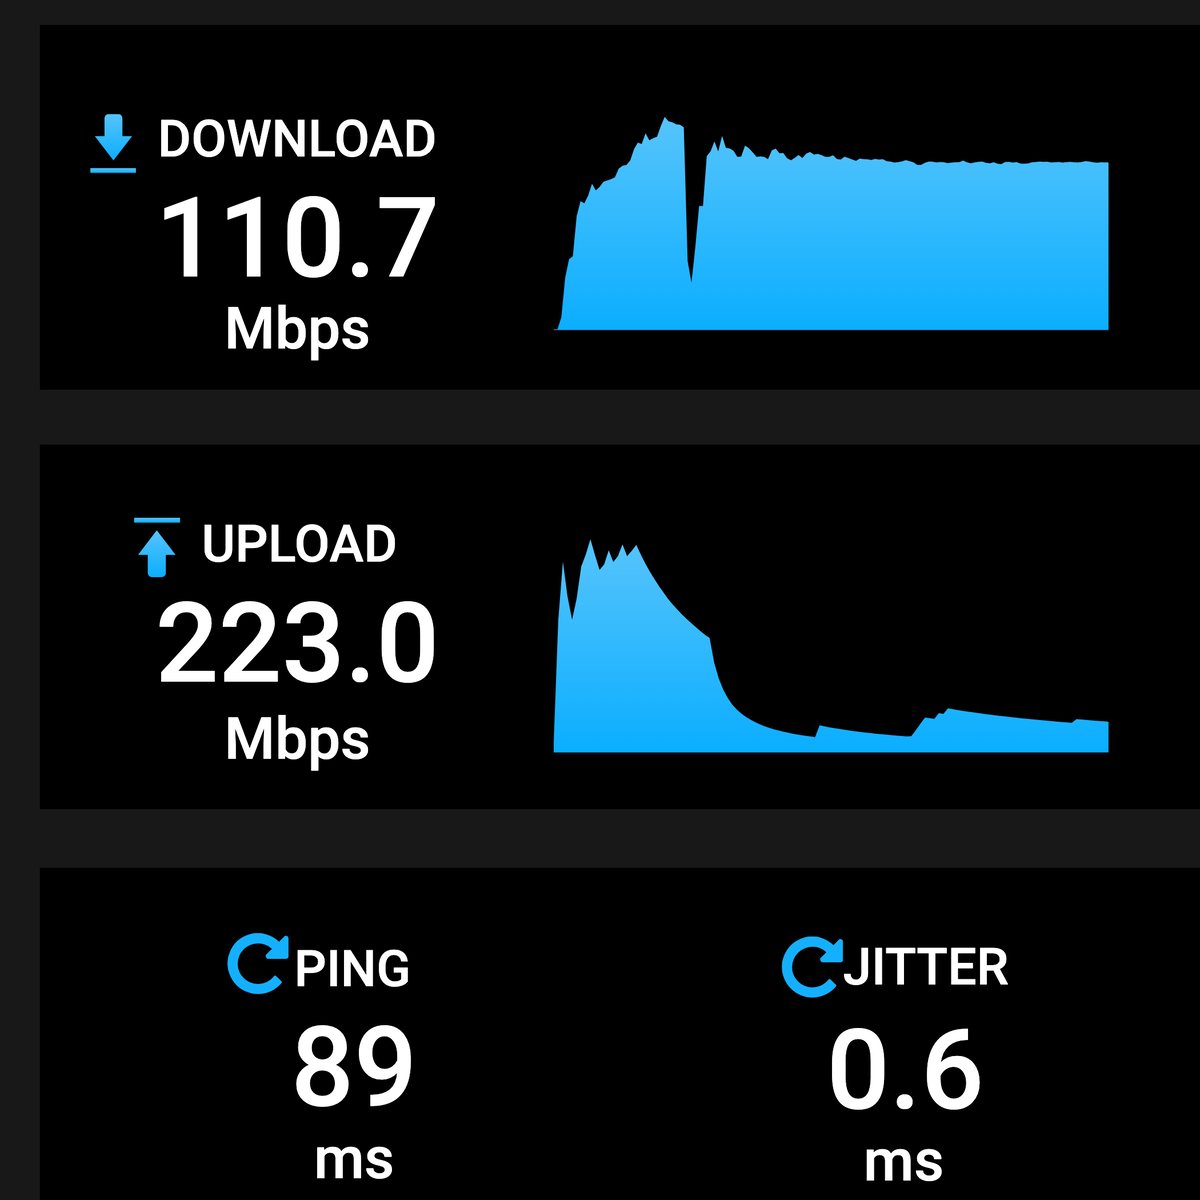
上一篇完成 reverse 多 lane 隔离后,VLESS/REALITY 方案从真实客户端测得下载 74.9 Mbit/s、上传 242.8 Mbit/s、Ping 88ms、Jitter 0.3ms。迁移到 Hysteria 2 后,在实际客户端重新运行 OpenSpeedTest,得到下载 110.7 Mbit/s、上传 223.0 Mbit/s、Ping 89ms、Jitter 0.6ms。
两张截图均裁去无关留白,并按相同结构并列展示:
| VLESS/REALITY | Hysteria 2 |
|---|---|
 |
 |
| 指标 | VLESS/REALITY 多 lane | Hysteria 2 | 变化 |
|---|---|---|---|
| 下载 | 74.9 Mbit/s | 110.7 Mbit/s | 提升约 47.8% |
| 上传 | 242.8 Mbit/s | 223.0 Mbit/s | 下降约 8.2% |
| Ping | 88ms | 89ms | 增加 1ms,基本持平 |
| Jitter | 0.3ms | 0.6ms | 增加 0.3ms,绝对值仍很低 |
两代方案的端到端延迟几乎相同,说明 Hysteria 2 的主要收益不是把两段公网距离“变短”,而是把下载从约 75 Mbit/s 提高到约 111 Mbit/s,并消除旧 reverse TCP 在持续负载后固化到 180–200ms 的状态。上传略有下降,但仍超过 200 Mbit/s,不是当前使用场景的瓶颈。
和上一篇的现场截图一样,这仍不是同一时刻、同一网络背景流量下的实验室 A/B。测速服务器负载、运营商时段和无线环境都可能影响数值;它适合说明迁移前后的实际体验,不应被解释成协议本身必然带来精确的 47.8% 提升。
NAS 文件复制
合成测速能说明链路具备足够的瞬时吞吐,但家庭入口最终还是要服务真实文件。因此我又从 macOS 已挂载的 NAS 目录复制一个 622,302,285B 的视频到本机:
1 | time rsync -ah --progress --partial \ |
1 | 欧洲野牛.mp4 |
按文件字节数和总耗时计算:
1 | 622,302,285 B ÷ 122.62 s ≈ 4.84 MiB/s ≈ 40.6 Mbit/s |
这组约 40.6 Mbit/s 是更贴近使用体验的端到端有效吞吐。它不应与 OpenSpeedTest 的 110.7 Mbit/s 下载结果直接比较:文件位于 macOS 挂载的 NAS 卷上,实际过程同时包含 NAS 磁盘、文件共享协议、macOS 客户端、单文件读写和 Hysteria 隧道的开销。它证明的是一个 622MB 真实文件能在约两分钟内稳定完成,而不是 Hysteria 本身的吞吐上限。
十二、这次迁移真正教会我的三件事
1. 限速必须发生在发送源
curl --limit-rate 测到的是客户端消费速度,不一定是隧道外层速率。只有在源端整形并读取发送字节计数,才能把 2、3、4、5 Mbit/s 变成可复现的实验条件。
2. PoC 的验收必须包括“重启之后”
正向请求成功、压测漂亮,都不代表方案能上线。PVE 断电暴露了临时 nftables、disabled unit 和 Fake-IP 地址生命周期三个问题。一次意外重启让控制面从“能跑”变成了“可恢复”。
3. 应用 ACL 后面还要有内核边界
应用层 reject(all) 是第一道门,UID-scoped nftables 是第二道门。防火墙缺失时 Server 必须停机,这才叫 fail-closed;自动放宽地址直到服务恢复,只是把可用性问题变成安全问题。
十三、结论
这次迁移并不能证明 QUIC 在所有网络上都优于 TCP,也不能把 3–4 Mbit/s 当成普遍的劣化阈值。它只证明了一个更有限、也更可靠的结论:在我的这条路径上,Xray reverse 的长寿命 TCP 会在持续负载后进入 179–193ms 的持久状态,而标准 Hysteria 2/QUIC 在 2–5 Mbit/s 阶梯、1 GiB 单流和 30 分钟持续流中没有复现这种跃迁。
选择 Hysteria 2 不是因为一张吞吐图,而是因为它同时满足了四件事:避开原来的长 TCP 故障模式、管理面在负载下保持可用、负向 ACL 能严格拒绝未授权目标、断电后能按 fail-closed 顺序恢复。相比 VLESS/REALITY 多 lane 的 74.9 Mbit/s,迁移后的下载现场值达到 110.7 Mbit/s;真实 NAS 文件复制也稳定得到约 40.6 Mbit/s 的端到端有效吞吐。
真正可上线的网络方案,从来不只是“跑得快”,还要能解释失败、限制失败,并且从失败里安全地回来。