一次 4 Mbit/s 下载,为什么让内网穿透延迟从 40ms 卡到 180ms?
这次问题最迷惑的地方,是线路明明有几十甚至上百兆带宽,SSH 却像隔着半个地球敲字。
我的访问路径是两段公网连接:Mac 先通过 VLESS/RAW/REALITY 到一台公网中继,再由 Xray 反向通道回到没有公网入口的 PVE 内网。平时反向段 RTT 大约 40ms,端到端交互尚可;某次下载后,SSH、PVE Web 和内网网页却一起变慢,而且停止下载几分钟仍然没有恢复。
最后发现,问题既不是 PVE 性能不足,也不是 REALITY 握手慢,而是承载 reverse mux 的那条长寿命 TCP 连接从约 40ms 固化到了 180ms。更麻烦的是,多种业务共享同一个外层连接,一条下载就能把管理面一起拖下水。
本文记录完整的排查、复现和改造过程。文中的域名、地址和主机名均已替换,测试数值保留自真实现场。
一、问题拓扑与现象
  flowchart LR
    client["Mac / 手机"]
    relay["公网中继<br/>203.0.113.10:443"]
    bridge["内网 Bridge VM"]
    pve["PVE / SSH / Web"]

    client -->|"VLESS + RAW + REALITY<br/>约 36–48 ms"| relay
    relay -->|"Reverse mux 长寿命 TCP<br/>正常约 40 ms,异常约 180 ms"| bridge
    bridge -->|"局域网 < 1 ms"| pve
客户端到公网中继的新连接一直在 36–48ms 左右,内网虚拟交换也只有 0.3–0.6ms。只有中继与 Bridge VM 之间那条已经存在很久的 reverse socket,RTT 高得离谱。
当时的体感和数据大致如下:
| 项目 | 异常时结果 |
|---|---|
| Bridge VM → 中继,新建 TCP | 41–44ms |
| 生产 reverse socket | 约 180ms |
reverse socket minrtt |
约 177.5ms |
| reverse socket 累计重传 | 约 787KB / 569 次 |
| 全新 SSH 建连 | 约 2.3–2.8 秒 |
| PVE 内网 RTT | 约 0.3ms |
同一台机器、同一个目的地址,新连接健康,旧连接却慢了 4 倍。这是整次排查里最重要的信号。
二、先排除几个很像答案的答案
1. 不要先相信客户端的 Ping
代理软件的 TUN 模式可能在本地代答 ICMP,甚至代做一部分 TCP 握手。此时 ping 显示 0.2ms,并不代表请求真的走完了公网往返。
比起只看客户端 Ping,我分别检查了每一段:
1 | # Bridge VM 到公网中继的 ICMP 基线 |
结果是公网基础路径约 39–44ms,内网亚毫秒,说明“所有连接天然都是 180ms”这个假设不成立。
2. 检查宿主资源与虚拟交换
1 | uptime |
现场 CPU 基本空闲,IO wait 为 0,可用内存约 29.5GB;vmbr1 没有 error、drop 或 backlog。PVE 和目标虚拟机也不是分别变慢,因为它们共享同一条反向路径。
3. BBR 不是万能修复
两端都已经启用 BBR + fq:
1 | sysctl net.ipv4.tcp_congestion_control |
1 | net.ipv4.tcp_congestion_control = bbr |
BBR 可以改善拥塞控制,但不能让一个已经被中间路径区别对待的五元组自动换路,也不能消除 TCP 可靠有序交付带来的队头阻塞。
4. REALITY 也不是路由器
REALITY 负责认证和流量外观,不负责选择运营商路径。修改 SNI、fingerprint、short ID 或 UUID,不会改变已经建立的 TCP 五元组。因此,在没有证据前反复换这些参数,只会引入新变量。
三、用 TCP_INFO 找到真正的慢连接
Linux 的 ss -ti 可以读取内核维护的 TCP_INFO。关键是找到 Xray 进程连接公网 443 的那个 socket,而不是随便测一次新的 HTTPS。
1 | # 找到服务 PID |
脱敏后的关键输出是:
1 | 192.168.50.13:45126 203.0.113.10:443 users:(("xray",pid=2418,fd=9)) |
这里的 rtt 是内核对这条真实生产连接的估计;minrtt 表示它从建立以来见过的最小 RTT。旧连接的 minrtt 都接近 178ms,而同机新建 TCP 只需 41–44ms,说明它从建立之初就没有采到当前健康路径。
为了避免单侧统计误差,我又在公网中继查看相同连接:
1 | sudo ss -Htinp state established '( sport = :443 )' |
中继侧约 182.7ms,两端结果一致。至此可以确认,慢点就在生产 reverse TCP,而不是浏览器、SSH 或内网目标机。
四、重建连接:有效,但只是止血
在维护窗口中,我只重启 Bridge VM 上负责反向连接的 Xray 实例:
1 | sudo systemctl restart xray-bridge |
配置、公网中继、PVE 和其他虚拟机都没有重启。新 socket 建立后,结果立刻变化:
| 指标 | 重连前 | 重连后 |
|---|---|---|
| Reverse socket RTT | 180.9ms | 43.7ms |
Reverse minrtt |
177.9ms | 41.6ms |
| 中继侧 RTT | 179.1ms | 42.6ms |
| 新 socket 累计重传 | — | 0 |
| 全新 PVE SSH | 2.36–2.82s | 1.10–1.34s |
| 全新 Ubuntu SSH | 2.25–2.61s | 1.22–1.38s |
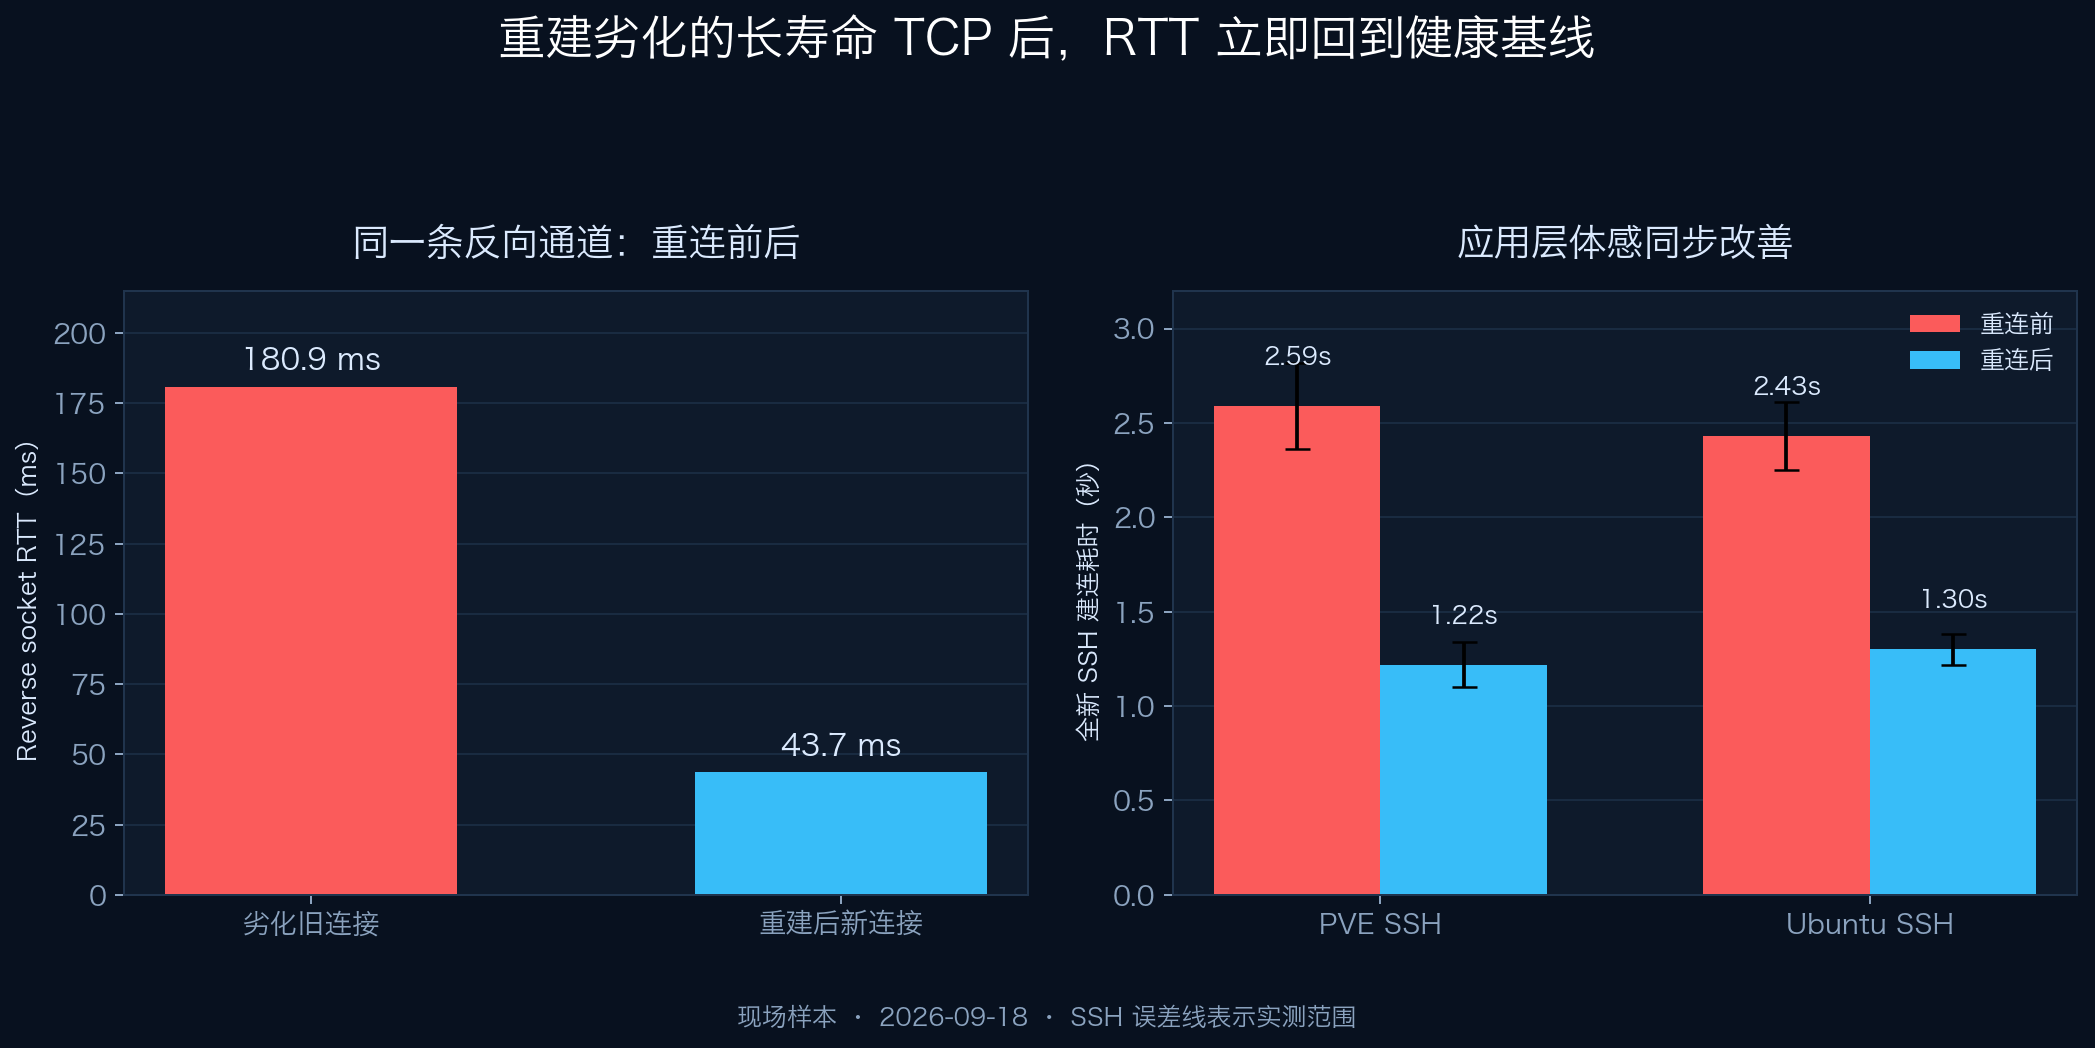
这次重连证明了“旧连接状态劣化”的判断,但它没有回答另一个问题:是什么让健康连接再次进入 180ms?
五、如何稳定复现:真正的坑在限速方法
最初我在 Mac 上使用:
1 | curl --limit-rate 2M https://internal.example/download.bin -o /dev/null |
这个方法不适合测反向隧道的触发阈值。客户端虽然慢慢读取,多层 TCP 接收窗口和中间缓冲仍允许源端提前发送几十 MB。客户端看到的 2M,不等于 reverse 外层只有 2M。
正确做法是从内网响应源头控制发送速率。测试时我临时启动了一个只绑定内网地址的 HTTP 服务,按固定大小分块发送,并且每档只持续约 25 秒。下面是等价的最小示例:
1 | import time |
测试期间持续读取唯一的 Xray→中继 socket,得到下面的结果:
| 源端持续速率 | Reverse RTT | 停止后状态 |
|---|---|---|
| 2 Mbit/s,25 秒 | 39.7–40.5ms | 恢复到 44–45ms |
| 3 Mbit/s,25 秒 | 多数 41–44ms,短暂 48.7ms | 约 42ms |
| 4 Mbit/s | 约 8 秒后升至 186.6–188.0ms | 持续劣化 |
| 5 Mbit/s | 约 4–12 秒后升至 180.7ms | 持续劣化 |
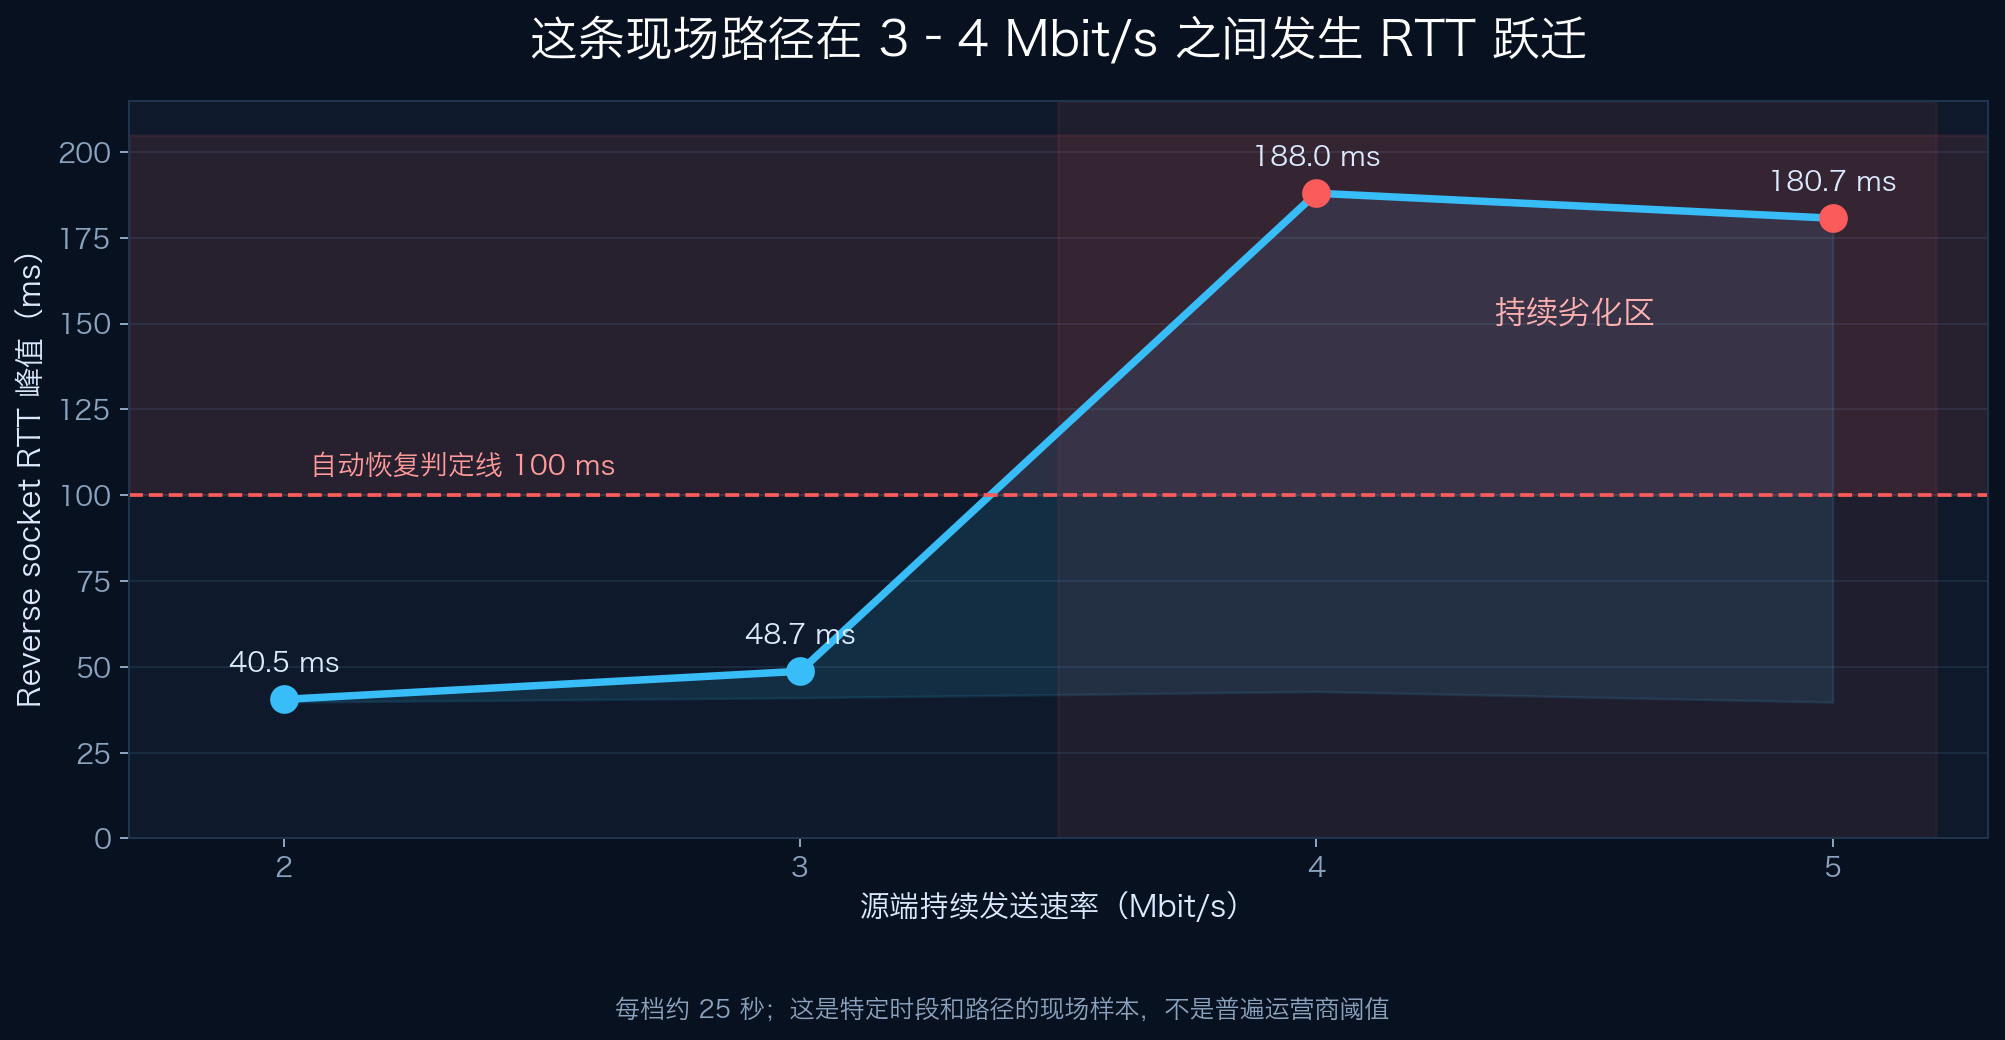
另一次 4 流、合计约 79Mbit/s 的有界下载,让生产 reverse RTT 从 42ms 升到 126ms,随后固定在 177–183ms;与此同时,同机新建 TCP 仍保持在 41–52ms。停止负载两分钟后,旧流也没有自行恢复,重建 socket 后则再次回到约 42ms。
这些证据能说明某个中间环节对单条持续流或其状态进行了区别处理,却不能仅凭端点数据断定是某家运营商的哪台设备、某种固定 QoS 算法或一次路径切换。3–4Mbit/s 也只是这个时段、这条路径的观察阈值,绝不是通用结论。
六、为什么一条下载会拖慢 SSH
旧版 Xray reverse 底层反向使用 Mux.Cool,把多个逻辑连接装进一条可靠字节流。Xray 官方也明确说明,Mux 的主要目标是减少握手延迟,不是提高下载或测速吞吐;大流量通常反而受到负面影响。
当外层 TCP 出现排队、重传或被固定到高延迟状态时,内层 SSH、Web 和下载都必须等待同一条外层字节流按序交付。这就是典型的共享故障域和队头阻塞:
1 | SSH ───────┐ |
单纯增大 TCP 缓冲、切换 BBR、打开客户端 Mux 或修改 REALITY 参数,都没有改变“所有业务共用一条外层 TCP”这个事实。
七、先自动恢复,再拆分故障域
1. 保守的健康检测
只检查 systemctl is-active 没用:进程活着、socket 也存在,不代表这条 socket 健康。最终监控每分钟读取真实 reverse socket,并同时建立三个全新 TCP 探针。
自动重连必须同时满足:
- 同一组生产 socket 连续三次 RTT 全部超过 100ms;
- 每轮三个新 TCP connect 全部低于 70ms;
- 采样连续,期间 socket 没有自然更换;
- 距上次重启至少 10 分钟;
- 每个实例一小时最多自动重启两次。
伪代码如下:
1 | bad_socket = all(item.rtt_ms > 100 for item in reverse_sockets) |
这套逻辑的重要之处,是区分“整个网络坏了”和“只有旧流坏了”。探针失败、socket 变化、采样中断或代码异常时一律不自动重启。
连续约 9.5 小时的观察中,共得到 566 个一分钟样本,RTT 范围 42.117–220.489ms,出现 6 个超过 100ms 的样本并触发两次受控重连,两次都在 5 秒内恢复到约 42ms。但自动重连仍是恢复措施:检测需要几分钟,而且会中断这条 lane 上的现有会话。
2. 从一条长流改为 management + bulk lanes
真正的工程解法,是不再让管理流量和大文件共用同一个故障域:
  flowchart LR
    user["客户端"] --> relay["VLESS / REALITY 公网入口"]
    relay --> mgmt["management lane<br/>SSH / PVE / LuCI"]
    relay --> bulk1["bulk-1"]
    relay --> bulk2["bulk-2"]
    relay --> bulk3["bulk-3"]
    relay --> bulk4["bulk-4"]
    mgmt --> lan["内网"]
    bulk1 --> lan
    bulk2 --> lan
    bulk3 --> lan
    bulk4 --> lan
我把 legacy reverse 迁到了 Xray 26 的 VLESS simplified reverse:
- 1 个独立进程只承载 SSH、PVE 8006 和路由管理页面;
- 4 个独立进程承载 HTTP、其他 TCP 和 UDP;
- 每条 lane 使用独立身份、PID 和 TCP 五元组;
- 健康检测只重启异常实例,不重启整个 Bridge VM;
- 路由层再次执行目标地址和端口白名单,默认拒绝。
灰度测试中,5 条连接的初始 RTT 都在 39–48ms。100 个短 HTTP 请求在 4 条 bulk lane 上分布为 27/22/22/29;停止其中一个实例后,20 个请求仍全部成功,恢复实例后会自动重新加入连接池。
最关键的一次验证是:30MiB 下载命中的 bulk-4 升到了约 199ms,但 management lane 同期仍为 49.7ms,SSH 没有被拖慢。健康检测随后只把 bulk-4 从 199.3ms 恢复到 44.7ms,其他 PID 没有变化。
这才是拆 lane 的价值:它不能保证某条 bulk TCP 永不劣化,但能把影响控制在一条可替换的连接内。
3. 实际端到端测速结果
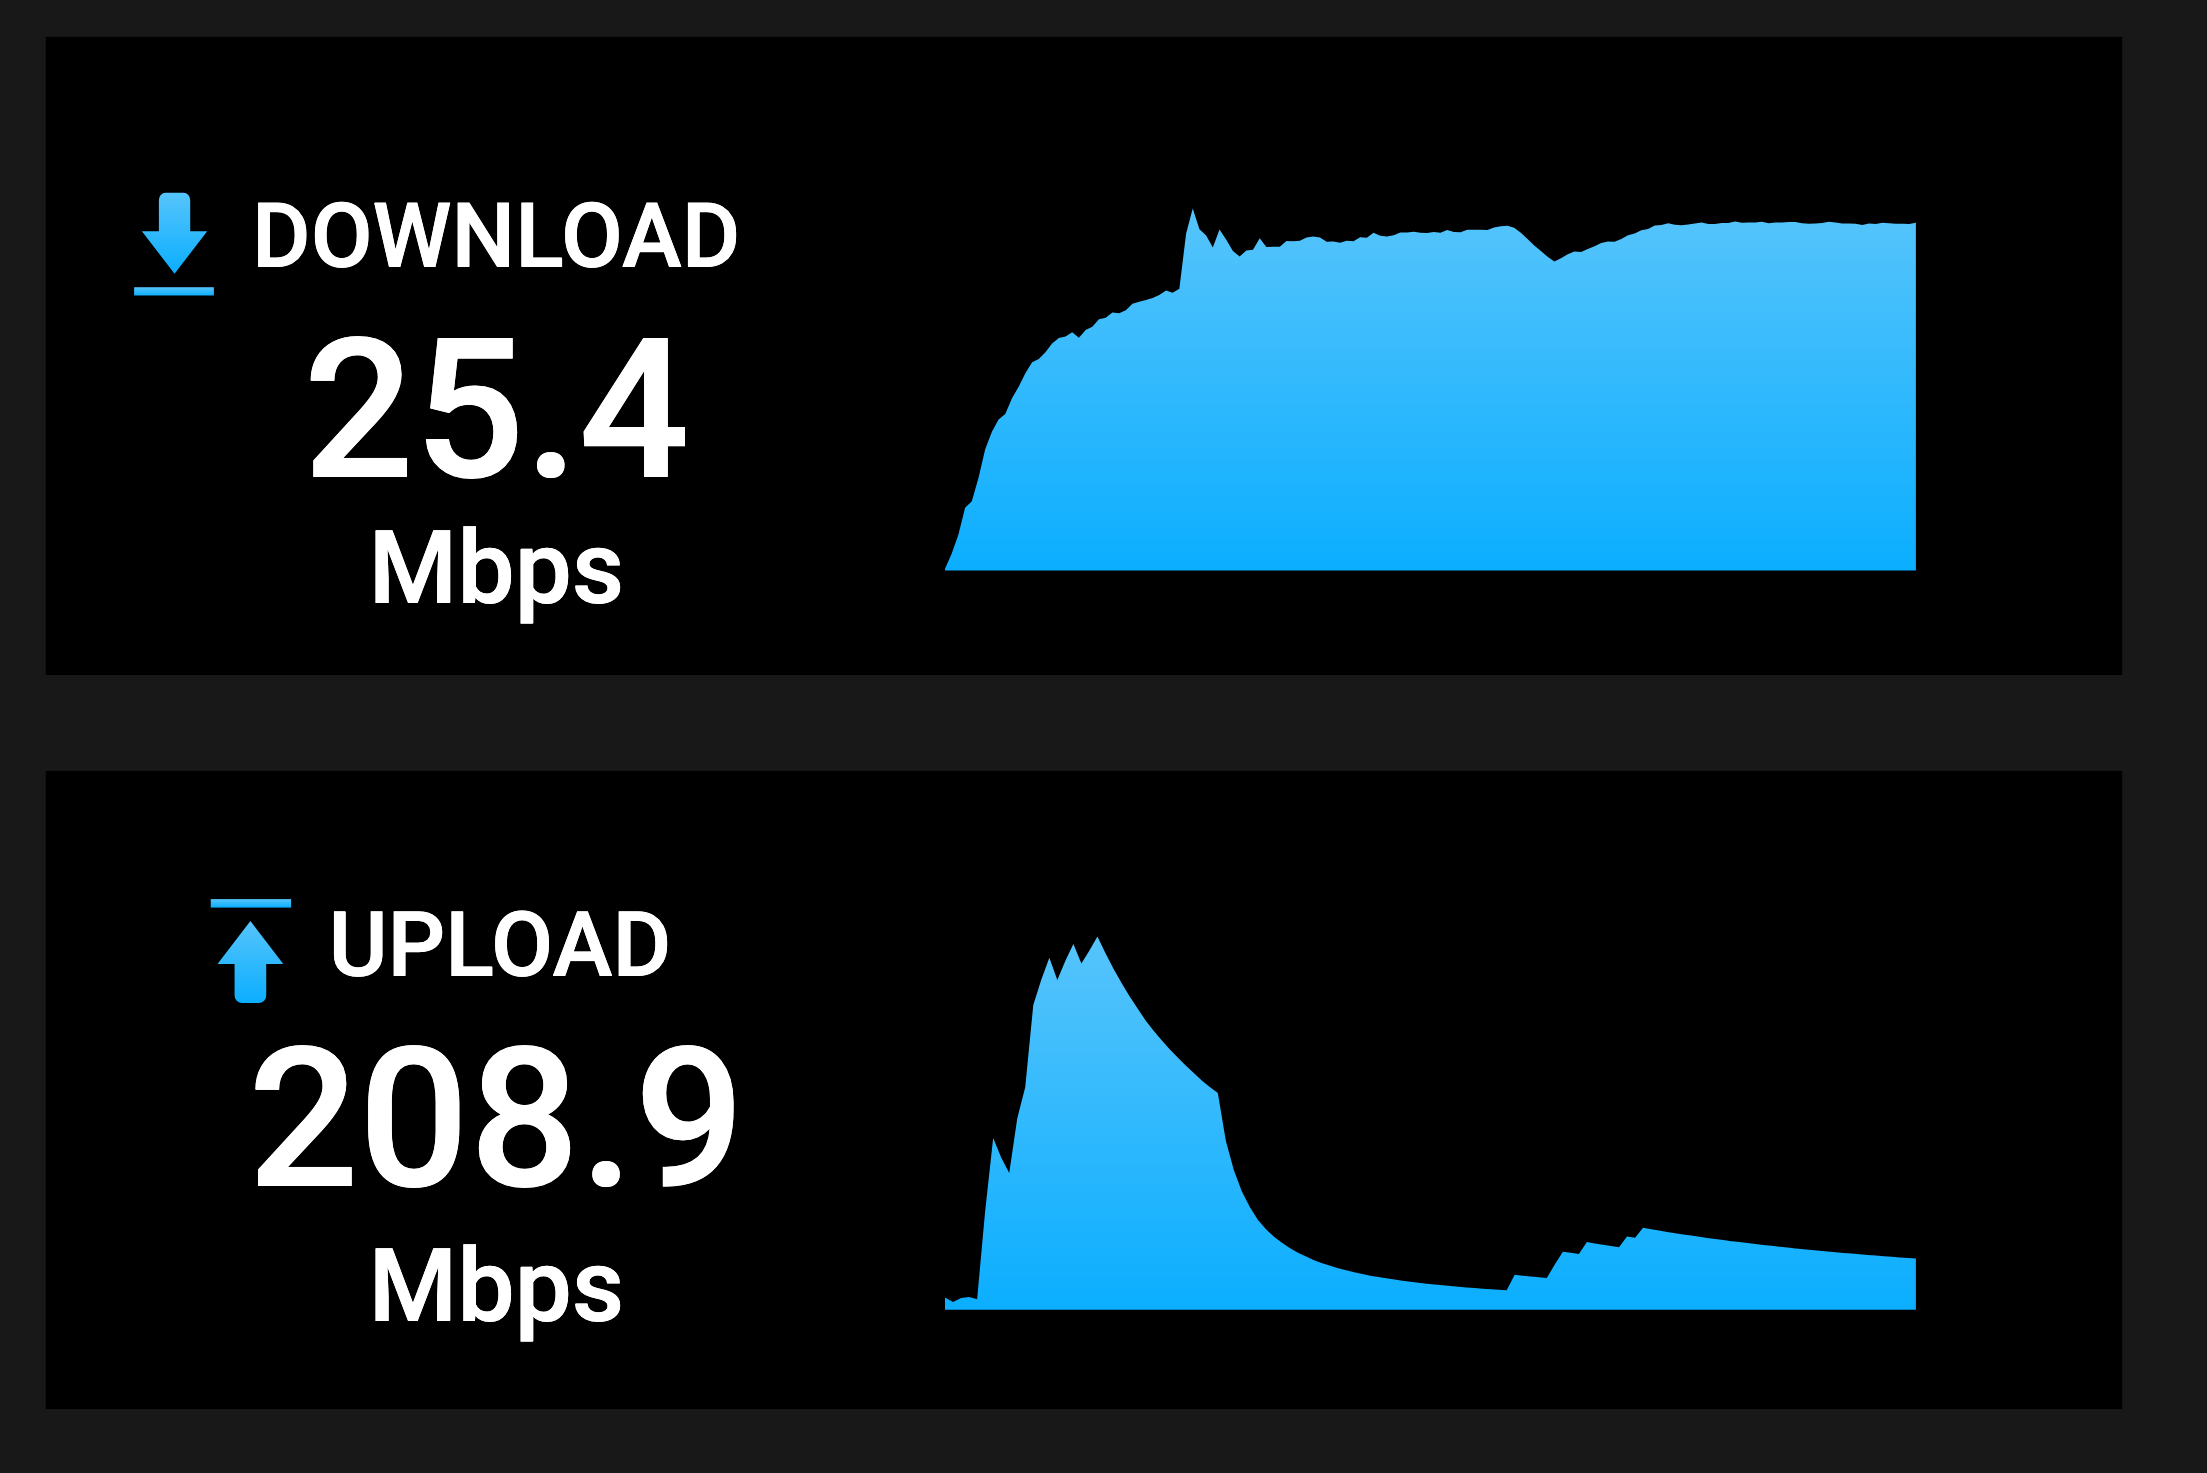
完成反向通道重建和多 lane 隔离后,我又从真实客户端做了两次端到端测速。优化前的现场截图如下:
优化后,在同一套访问链路上重新测试:
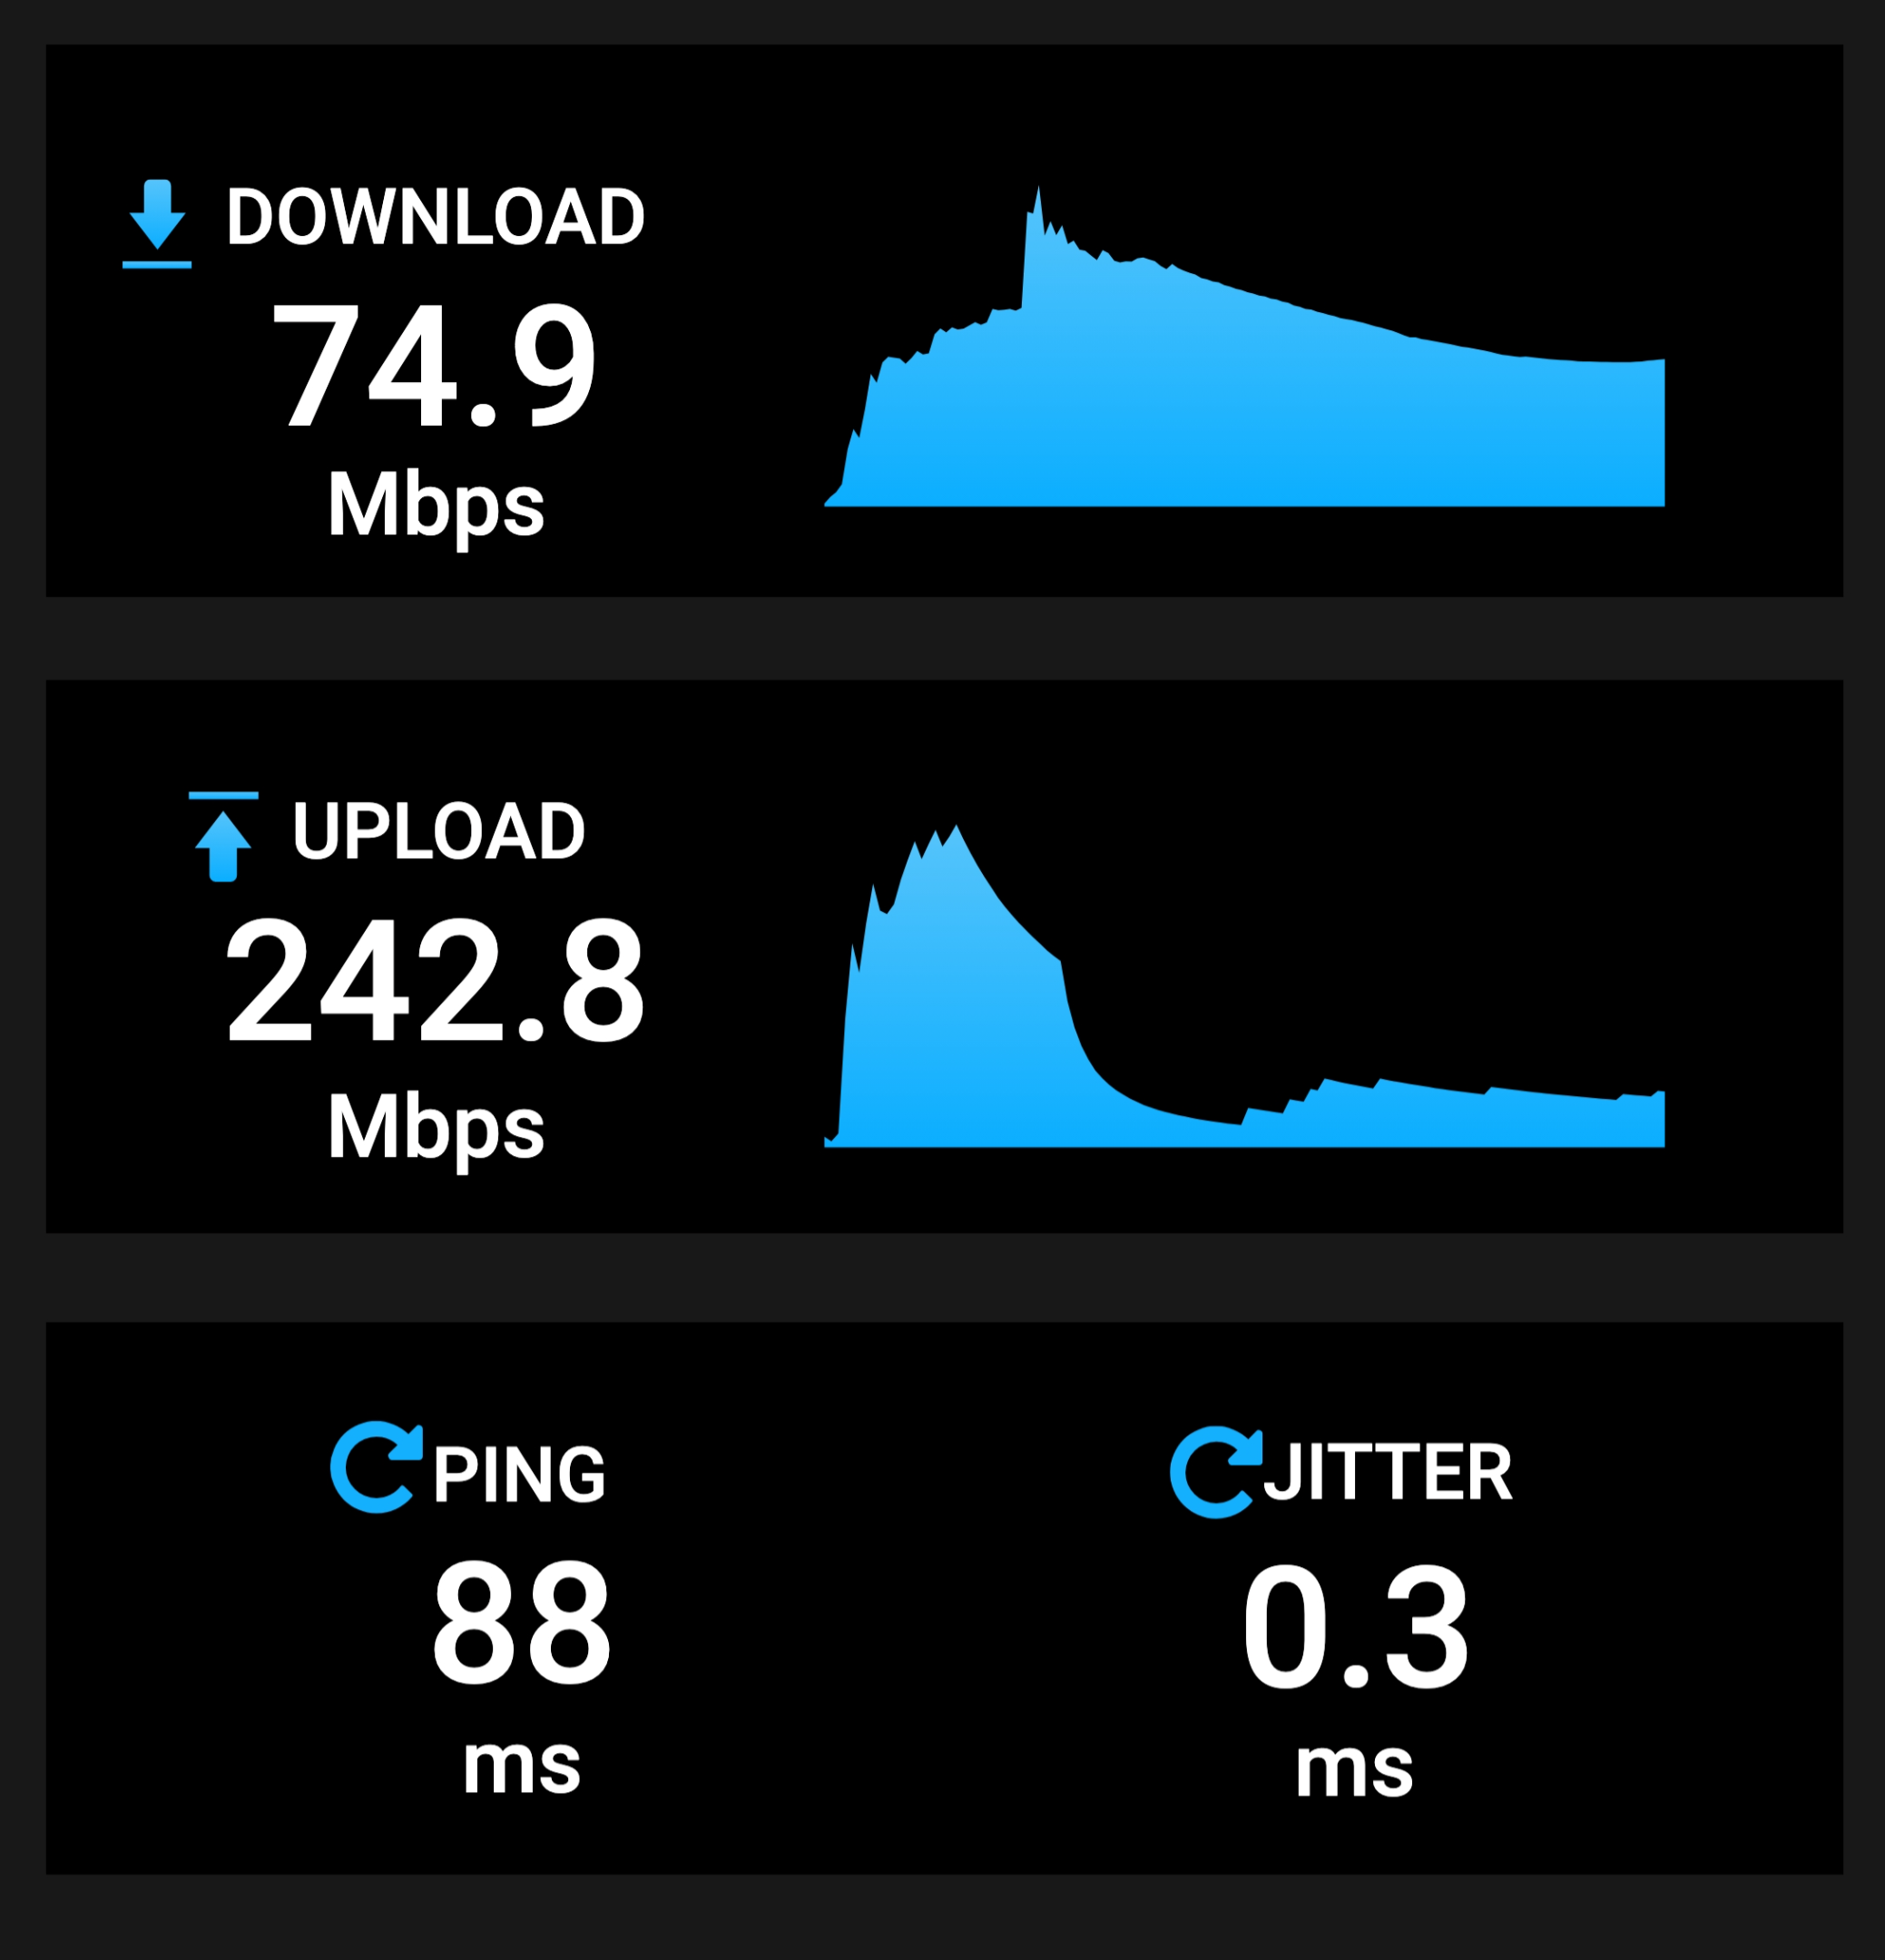
| 指标 | 优化前 | 优化后 | 变化 |
|---|---|---|---|
| 下载 | 25.4 Mbps | 74.9 Mbps | 约 2.95 倍,提升 194.9% |
| 上传 | 208.9 Mbps | 242.8 Mbps | 提升 16.2% |
| Ping | 截图未记录 | 88 ms | 不做百分比比较 |
| Jitter | 截图未记录 | 0.3 ms | 优化后现场值 |
下载提升最明显:从只能跑到约 25 Mbps,提高到接近 75 Mbps。优化后的 88 ms Ping 也落在前文估算的双段公网健康下限 80–100 ms 内,说明交互路径已经回到合理区间。上传原本就没有被同样程度地限制,因此增幅相对较小。
需要注意,这两张图是生产环境的现场快照,不是实验室中的严格 A/B 基准:测速服务器负载、运营商时段和并发流数量都可能影响结果。它们能证明改造后的真实使用体验和端到端吞吐明显改善,但多 lane 方案更重要的收益,仍然是前面已经单独验证过的故障隔离——即使一条 bulk lane 再次升到约 199 ms,management lane 仍可保持约 50 ms。
八、部署、验证与回滚
生产切换前,两端配置都应先离线检查:
1 | sudo xray run -test -config /etc/xray/config.json |
至少验证这些场景:
- SSH、PVE UI、路由管理页面只进入 management;
- 普通 HTTP 和 UDP 进入 bulk;
- 私网白名单外的目标被拒绝;
- 停止任一 bulk 实例后,新请求仍能完成;
- 人为劣化一条 bulk lane 时,management RTT 保持正常;
- 健康监控只重启目标实例;
- 普通 HTTPS fallback 不受影响。
迁移开关应保留 legacy 与 simplified 两种模式。观察期发现异常时,只需把服务端路由切回 legacy、重新生成配置并重启公网入口;旧 Bridge 服务在 72 小时内保留运行,客户端节点和入口地址无需修改。观察期结束后再删除旧 portal、凭据和 unit。
九、结论与边界
这次事故最有价值的经验,不是“重启 Xray 就好了”,而是下面四点:
- 测新连接不能代表长寿命生产连接,必须直接观察真实 socket 的
TCP_INFO; - 多条逻辑业务复用一条外层 TCP,会把单流问题放大成系统性故障;
- 自动重连需要用健康新探针对照,避免在全网故障时制造重启风暴;
- 管理面和数据面应该拥有独立的连接、进程与恢复边界。
在两段公网中转的物理拓扑下,健康目标仍是约 80–100ms,不可能靠修改 Xray 参数变成局域网延迟。如果要求低于 50ms,必须减少中转距离或更换更近、更稳定的落点。
最后再次强调:本文能证明的是“一条生产长流进入持续高 RTT,重建后恢复,多 lane 能隔离影响”;不能证明某个运营商存在固定的 4Mbit/s 限速策略。做网络排障时,保留这条证据边界,比给现象找一个听起来确定的故事更重要。